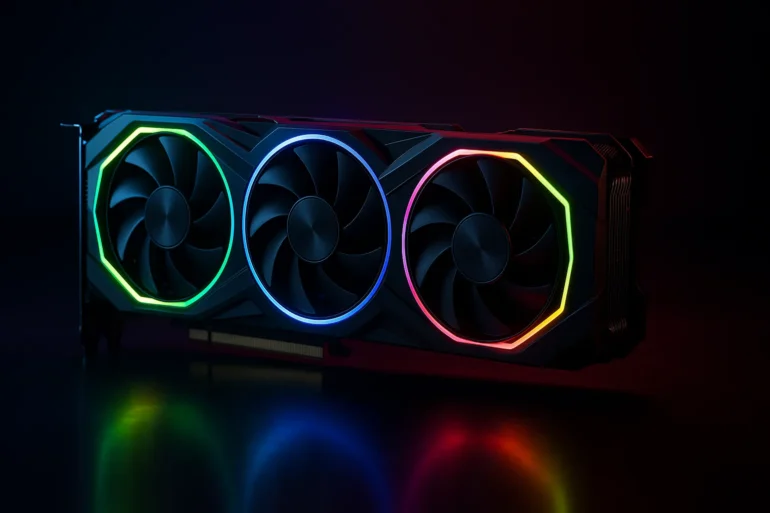
Existe uma foto que circula entre entusiastas de hardware como se fosse uma relíquia arqueológica: uma placa de vídeo 3dfx Voodoo Graphics original, de 1996, ao lado de uma NVIDIA GeForce RTX 5090. A Voodoo cabe na palma da mão. A RTX 5090 é maior do que algumas caixas de sapato. Trinta anos separam as duas — e a diferença de tamanho não é acidente, capricho de design ou exibicionismo dos fabricantes. É a consequência física inevitável de uma corrida por desempenho que nunca desacelerou.
A pergunta parece simples: por que as GPUs ficaram tão grandes? A resposta passa por física, termodinâmica, a evolução dos processos de fabricação de chips, a demanda por memória de alta largura de banda e, nos últimos anos, a explosão da inteligência artificial. Entender esse caminho é entender a história do hardware moderno — e por que o seu próximo gabinete talvez precise ser maior do que o atual.
O começo: quando a GPU cabia em qualquer slot
Nos anos 1990, o conceito de “placa de vídeo” era quase burocrático. A S3 Trio, a Cirrus Logic e até a primeira geração de cards da NVIDIA (então chamados de NV1, de 1995) eram placas finas, discretas, que ocupavam um único slot ISA ou PCI e raramente precisavam de cooler ativo — um dissipador de alumínio passivo, quando havia algum, bastava. A 3dfx Voodoo Graphics, lançada em 1996 e considerada por muitos historiadores de hardware como a GPU que popularizou a aceleração 3D para games, consumia menos de 10 watts. Cabia em qualquer gabinete ATX da época sem o menor drama.
O salto começa a aparecer com a chegada do barramento AGP em 1997 e, principalmente, com a GeForce 256 da NVIDIA em 1999 — batizada pela empresa como a “primeira GPU do mundo”, por integrar pela primeira vez a transformação e iluminação geométrica (T&L) diretamente no chip. Mais funções no silício significavam mais transistores. Mais transistores significavam mais calor. E mais calor exigia soluções de resfriamento maiores. A lógica que ditaria as próximas três décadas estava estabelecida.
A era do slot duplo: quando o calor virou o inimigo número um
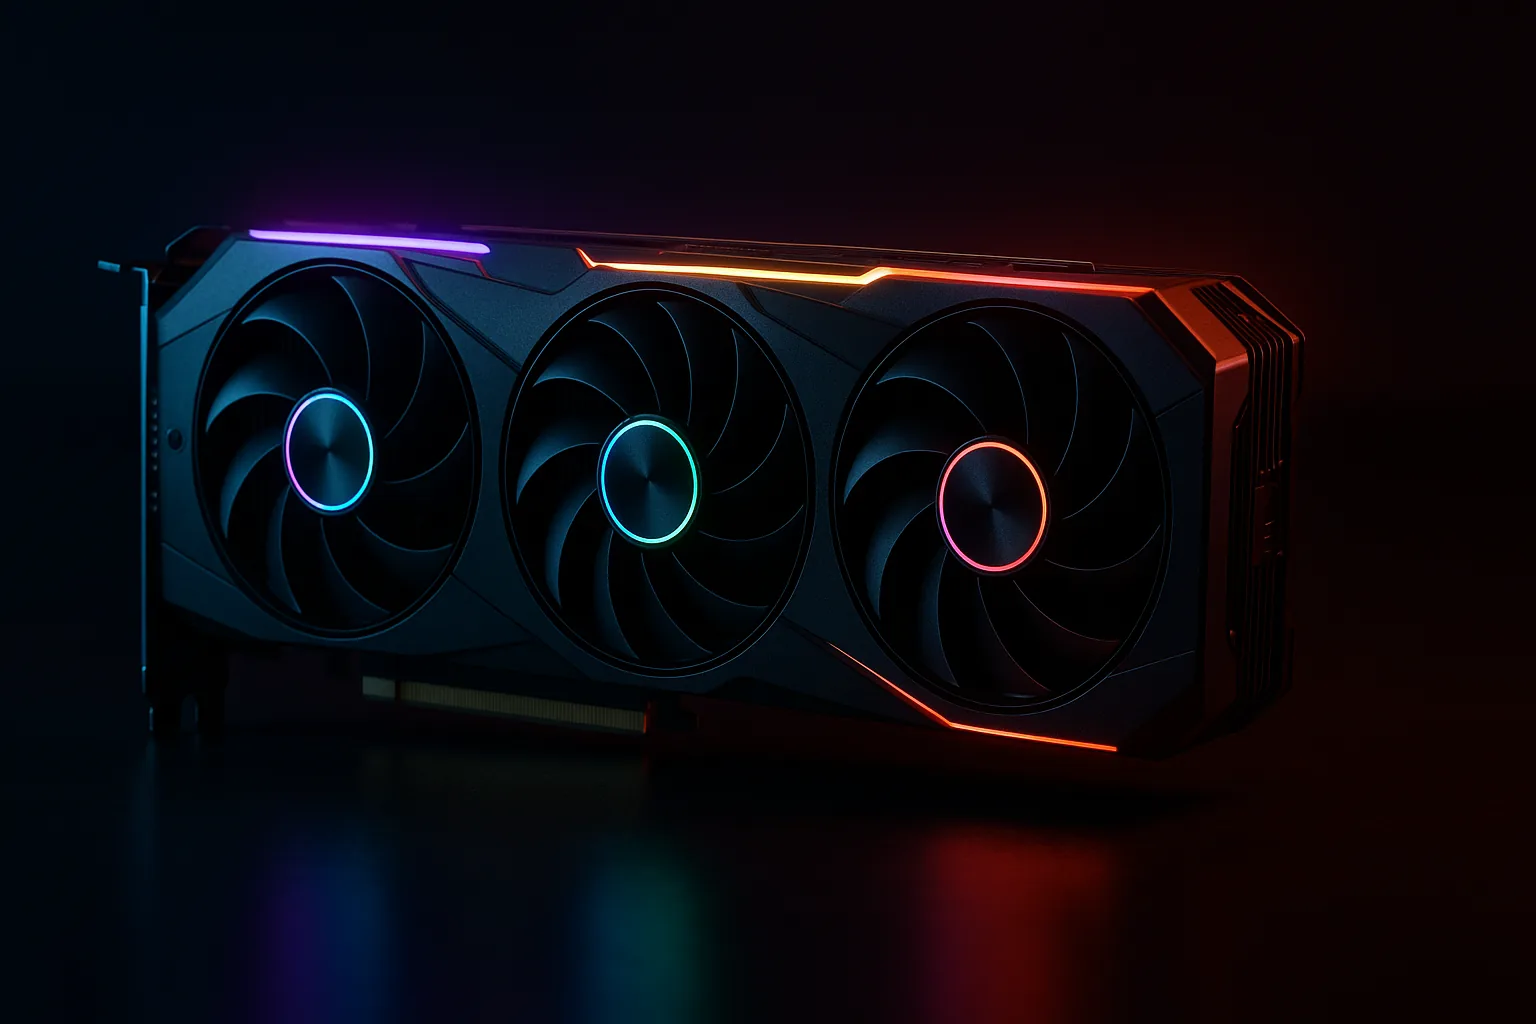
A virada para o slot duplo acontece no início dos anos 2000, com a ATI Radeon 9700 Pro (2002) e a NVIDIA GeForce FX 5800 Ultra — esta última ficou famosa (ou infame) pelo cooler barulhento apelido de “dustbuster”, o aspirador de pó, tamanho o ruído que fazia. Eram as primeiras GPUs de alto desempenho que precisavam ocupar dois slots de expansão para acomodar o sistema de resfriamento. O motivo era direto: chips fabricados em processos de 150 nm a 130 nm, rodando a frequências cada vez maiores, geravam dezenas de watts de calor que um dissipador de slot único simplesmente não conseguia dissipar.
A indústria inteira migrou para o padrão de dois slots ao longo dos anos 2000. O PCI Express, introduzido em 2004, foi um catalisador: além de oferecer maior largura de banda, o padrão foi desenhado para fornecer até 75 W diretamente pelo slot — e os conectores auxiliares de alimentação (primeiro o de 6 pinos, depois o de 8 pinos) permitiram que as GPUs consumissem 150 W, 200 W e além. Com mais energia disponível, os fabricantes não hesitaram em usar.
| GPU | Ano | TDP (W) | Slots ocupados | Processo (nm) |
|---|---|---|---|---|
| 3dfx Voodoo Graphics | 1996 | ~9 W | 1 | 500 nm |
| NVIDIA GeForce 256 | 1999 | ~23 W | 1 | 220 nm |
| ATI Radeon 9700 Pro | 2002 | ~60 W | 2 | 150 nm |
| NVIDIA GeForce 8800 GTX | 2006 | ~155 W | 2 | 90 nm |
| AMD Radeon RX 480 | 2016 | ~150 W | 2 | 14 nm |
| NVIDIA RTX 3090 | 2020 | 350 W | 3 | 8 nm |
| NVIDIA RTX 4090 | 2022 | 450 W | 3-4 | 4 nm |
| NVIDIA RTX 5090 | 2025 | 575 W | 4 | 4 nm (TSMC N4P) |
A armadilha da Lei de Moore: mais transistores, mais calor
Aqui mora um paradoxo fascinante. A Lei de Moore — a observação de Gordon Moore, cofundador da Intel, de que o número de transistores em um chip dobra aproximadamente a cada dois anos — prometia chips menores e mais eficientes. E de fato, um transistor fabricado em 4 nm consome muito menos energia do que um em 90 nm. O problema é que a indústria nunca usou essa eficiência para manter o consumo estável: usou para enfiar mais transistores ainda no mesmo espaço, aumentando o desempenho bruto.
A RTX 5090 contém aproximadamente 92 bilhões de transistores. A Voodoo Graphics original tinha cerca de 1 milhão. São 92.000 vezes mais transistores — e o chip fisicamente não cresceu na mesma proporção, mas o calor gerado por toda aquela operação paralela exige um sistema de resfriamento que sim, cresceu muito.
Esse é o ponto central que muita gente não percebe: o die (o chip de silício em si) não ficou gigante — ele ficou mais denso. O que cresceu de forma desproporcional foi o sistema de resfriamento. Uma RTX 4090 tem um die de cerca de 608 mm² — grande, mas não absurdo. O que faz a placa medir mais de 33 cm de comprimento e ocupar 3 ou 4 slots são as heatpipes de cobre, as câmaras de vapor (vapor chambers), os três ventiladores de 100 mm e as aletas de alumínio que precisam dissipar até 450 W de calor contínuo.
GDDR e HBM: a memória que também tomou espaço
Outro fator frequentemente ignorado é a memória de vídeo. As GPUs modernas de alto desempenho usam GDDR7 ou HBM (High Bandwidth Memory), e ambas as tecnologias têm implicações físicas diretas no tamanho da placa. O GDDR7, usado na RTX 5090, opera em barramentos de 512 bits — o que significa 16 chips de memória dispostos ao redor do die central na PCB (placa de circuito impresso). Cada um desses chips ocupa espaço físico e gera calor próprio.
Já o HBM, usado em GPUs profissionais como a AMD Instinct MI300X e as NVIDIA H100/H200 voltadas para IA, empilha camadas de memória verticalmente usando conexões chamadas TSV (Through-Silicon Via), o que reduz a área de PCB ocupada — mas aumenta dramaticamente o custo e a complexidade do encapsulamento. Ironicamente, as GPUs de IA mais poderosas do mundo às vezes são fisicamente menores em área de PCB do que uma RTX de consumidor, mas custam entre R$ 150.000 e R$ 500.000 a unidade.
A chegada dos 3 e 4 slots: a geração Ampere em diante
A NVIDIA GeForce RTX 3000 (arquitetura Ampere, 2020) foi o momento em que o slot triplo deixou de ser exceção e virou regra nos modelos topo de linha. A RTX 3090, com TDP de 350 W, exigiu um cooler tão volumoso que a placa passou a ocupar 3 slots completos — e algumas versões de parceiros como ASUS ROG e EVGA chegavam a 3,5 slots, causando os primeiros relatos em massa de GPUs que bloqueavam slots de expansão vizinhos e não cabiam em gabinetes mid-tower convencionais.
A geração Ada Lovelace (RTX 4000, 2022) aprofundou o problema. A RTX 4090 referência da NVIDIA já ocupa 3 slots, mas versões customizadas de parceiros — como a ASUS ROG STRIX RTX 4090 — chegam a 3,5 slots e mais de 35 cm de comprimento. Com a RTX 5090 (arquitetura Blackwell, início de 2026) e seu TDP de 575 W, o slot quádruplo tornou-se realidade comercial: algumas versões AIB (Add-In Board, os modelos de parceiros) chegam a 4 slots completos e comprimento superior a 36 cm.
O novo conector de alimentação PCIe 5.0 de 16 pinos (batizado de 12VHPWR e depois 12V-2×6 na revisão de segurança), capaz de fornecer até 600 W por um único cabo, foi desenvolvido justamente para acompanhar essa escalada. Não à toa, ele também gerou polêmica: relatos de derretimento do conector na RTX 4090 em 2022 e 2023 foram investigados pela NVIDIA e atribuídos principalmente a conexões não completamente encaixadas — um problema real, documentado e que levou à revisão do design no padrão 12V-2×6.
IA acelerou tudo — literalmente
Se os games já empurravam as GPUs para o limite, a explosão da inteligência artificial generativa a partir de 2022 jogou querosene na fogueira. Treinar e rodar modelos de linguagem de grande escala (LLMs) como os que alimentam assistentes de IA exige operações massivas de multiplicação de matrizes — exatamente o que as GPUs fazem melhor. A NVIDIA percebeu isso antes de todo mundo e passou a projetar GPUs de consumidor com Tensor Cores (núcleos especializados em operações de IA) desde a arquitetura Turing, em 2018.

O resultado é que hoje uma RTX 5090 não é só uma GPU de games: é uma estação de inferência de IA que também joga. Essa dualidade de propósito justifica, aos olhos da NVIDIA, tanto o preço (a RTX 5090 custa cerca de US$ 1.999 nos EUA — o que, com impostos de importação e câmbio, chega a R$ 15.000 a R$ 20.000 no Brasil dependendo da cotação) quanto o tamanho físico. Mais Tensor Cores, mais VRAM (a 5090 vem com 32 GB de GDDR7), mais calor, mais cooler, mais espaço.
O futuro: vai encolher ou continuar crescendo?
Há dois caminhos sendo explorados pela indústria. O primeiro é o resfriamento líquido integrado: a NVIDIA lançou versões com waterblock de fábrica (como a RTX 4090 Founders Edition com kit de líquido opcional) e parceiros como ASUS e MSI oferecem modelos com cooler líquido all-in-one integrado, que reduzem a espessura da placa mas exigem radiador externo no gabinete. O segundo caminho é o empacotamento avançado (chiplet design): dividir a GPU em múltiplos dies menores e conectá-los com interposers de alta velocidade, como a AMD já faz com CPUs e começa a explorar em GPUs. Isso pode permitir GPUs de altíssimo desempenho em formatos mais compactos — mas a tecnologia ainda não chegou ao mercado de consumo de forma plena em 2026.
O que é certo é que a corrida não vai parar. Enquanto houver demanda por mais desempenho gráfico e mais capacidade de IA local, a física vai continuar cobrando seu preço em watts, centímetros e slots de expansão. A Voodoo Graphics era uma plaquinha discreta que ninguém notava dentro do gabinete. A RTX 5090 é o componente mais imponente de qualquer build — e provavelmente o mais caro também. Trinta anos de progresso tecnológico, resumidos em tamanho.
Perguntas frequentes (FAQ)
O chip de silício (die) cresceu, mas não proporcionalmente ao tamanho da placa. O que ocupa os slots extras é o sistema de resfriamento: heatpipes, câmaras de vapor, três ventiladores e aletas de alumínio necessários para dissipar até 575 W de calor gerado por bilhões de transistores operando em paralelo.
Há dois caminhos: resfriamento líquido integrado (que reduz a espessura mas exige radiador externo) e design chiplet, dividindo o processador em múltiplos dies menores. Nenhuma das duas soluções chegou ao mainstream de consumo de forma plena em 2026, então o crescimento ainda não reverteu.
Houve relatos reais de derretimento do conector 12VHPWR em RTX 4090 em 2022-2023, investigados pela NVIDIA e atribuídos principalmente a conexões não completamente encaixadas. O padrão foi revisado para o 12V-2×6, com trava de segurança melhorada. Conectado corretamente, o risco é mínimo.
A tributação sobre importação de eletrônicos no Brasil pode somar entre 80% e 90% sobre o valor do produto, incluindo II (Imposto de Importação), IPI, PIS/COFINS e ICMS estadual. Somado à variação do câmbio, o preço final em real pode ser duas a três vezes o valor em dólar nos EUA.
Fatos rápidos que você provavelmente não sabia
- A 3dfx Voodoo Graphics não tinha saída de vídeo própria: precisava ser conectada em série com outra placa 2D, usando um cabo externo chamado “pass-through”.
- O nome “GPU” (Graphics Processing Unit) foi cunhado pela própria NVIDIA em 1999 para o lançamento da GeForce 256 — antes disso, o termo técnico era simplesmente “acelerador gráfico”.
- A NVIDIA GeForce FX 5800 Ultra (2003) era tão barulhenta que alguns reviews da época mediram seu ruído em mais de 60 dB — comparável a uma conversa em tom elevado. Virou piada na indústria e contribuiu para a ATI ganhar market share naquele ciclo.
- No Brasil, a tributação sobre importação de GPUs pode chegar a 80-90% sobre o valor do produto, o que explica a diferença brutal entre o preço em dólar e o preço em real nas lojas nacionais.
- A AMD Radeon RX 480, em 2016, ficou famosa por um bug de driver que fazia a placa puxar mais energia do que o slot PCI Express suportava — um problema que poderia, em teoria, danificar a placa-mãe. A AMD corrigiu via driver em dias.
